HealyのPDFが二つ、三つと増えると、「全部まとめて送って、違いを見て」と頼みたくなります。
けれど、ファイル名が似ていたり、ページ構成が少し違ったりすると、どの資料の記述なのか分からない比較表ができることがあります。きれいに整理されていても、欠けた項目を「変化」として扱っていたら、その比較は使えません。
複数PDFを比較するときは、最初に各ファイルへ固定IDを付け、内容を混ぜずに一冊ずつ監査します。その後、同じ形式・範囲で比較できるかを確認し、「共通」「片方だけ」「欠損・判読不能」を分けた共通軸の表を作ります。各結果にはファイルIDとページ位置を残します。
ポイントは、最初から「意味のある変化」を探さないことです。比較できる状態を作る工程と、比較結果を読む工程を分けます。
まず資料A、資料Bと名前を固定する
アップロード前に、ファイルの呼び名を決めます。
資料A:2026-08-01_確認用.pdf
資料B:2026-08-15_確認用.pdf
資料C:2026-08-29_確認用.pdf
元のファイル名を変更できない場合は、最初の指示で対応関係を書けば構いません。
この会話では、report_01.pdfを資料A、report_02.pdfを資料Bとして扱ってください。以後の回答では、必ず資料IDを明記してください。
日付だけでなく、誰の資料か、何の目的で保存したものかも、自分が区別できる範囲で記録します。ただし、AIへ渡す必要のない氏名、連絡先、会員情報などは隠します。
一冊ずつ「読めた範囲」を監査する
比較の前に、各PDFを別々に確認させます。ここでは内容を解釈せず、資料の在庫表を作るイメージです。
確認項目は次の六つです。
1. 資料ID
2. 日付または識別情報
3. ページ数
4. 見出し・セクション名
5. 読み取れた項目数
6. 欠け、重複、判読できない部分
資料Aと資料Bをまだ比較しないでください。各資料を別々に確認し、ページ数、見出し、項目数、欠損、判読不能箇所を一覧にしてください。推測で補わず、確認できない箇所は「不明」としてください。
この段階でページの欠けや文字の崩れが見つかれば、比較へ進まず、元PDFを確認します。存在しない項目と、読めなかった項目は別物です。
同じ土俵で比較できるかを確かめる
二冊ともPDFだからといって、必ず比較できるわけではありません。
たとえば、一方は全ページ、もう一方は抜粋版かもしれません。見出しは似ていても、対象範囲や並び順が違うこともあります。形式が異なる資料をそのまま左右に置くと、「掲載されていない」が「なくなった」に変換されてしまいます。
比較前に、次を確認します。
同じ種類の資料か
対象範囲が同じか
見出しや列の意味が対応しているか
ページや項目の欠損がないか
値の単位や表記が同じか
一致しない場合は、無理に一枚の表へ統合しません。「比較可能」「条件付きで比較可能」「比較不能」に分け、条件付きなら比較できる範囲を限定します。
比較軸を先に指定する
「違いを全部教えて」では、AIが何を重要とみなしたのか分かりません。比較軸を先に決めます。
実務で使いやすい軸は、次の四つです。
両方にある同名項目
表記や値が異なる項目
片方だけにある項目
欠損または判読不能で比較できない項目
表の列も固定します。項目/資料A/資料B/差分/欠損・不明/出典位置。
ここでの「差分」は、画面や資料に表示された違いです。原因、良し悪し、身体状態などの説明を混ぜません。
出典をファイルIDとページで残す
比較表の数字だけを後から見ても、原資料へ戻れなければ検品できません。
回答には、資料IDとページ番号、可能なら見出し名を付けてもらいます。
各セルの根拠を「資料A・3ページ・○○欄」の形式で記載してください。ページ番号を確認できない場合は、見出し名とページ内の位置を書き、推測したページ番号を作らないでください。
PDF上の印刷ページ番号と、ビューアーの通し番号がずれることもあります。どちらを使ったか分かる書き方にしておくと、照合しやすくなります。
そのまま使える比較プロンプト
個別監査が終わった後に、次のように依頼します。
資料A=「2026-08-01」、資料B=「2026-08-15」です。まず、それぞれの読み取り範囲を別々に監査し、同じ種類・対象範囲・項目構成かを確認してください。比較可能な共通項目だけを、項目/資料A/資料B/差分/欠損・不明/出典ページの列で表にしてください。片方に存在しない項目を0として扱わないでください。表記を勝手に言い換えず、判読できない箇所は推測せず「不明」としてください。まだ原因や良し悪しは解釈しないでください。
表ができたら、原PDFから数項目を選び、ID、値、単位、ページ位置を照合します。最初から全行を信用するのではなく、比較の作り方が守られているかを抜き取り確認します。
ファイルが多いときは小分けにする
OpenAIの公式FAQでは、ファイルアップロードは複数文書の比較に使える一方、ファイルサイズ、トークン数、一定時間内のアップロード数、プランやプロジェクトごとのファイル数には上限があります。上限は変更される可能性があるため、利用時点の公式案内を確認してください。
ただし、上限まで一度に投入できることと、検品しやすいことは別です。
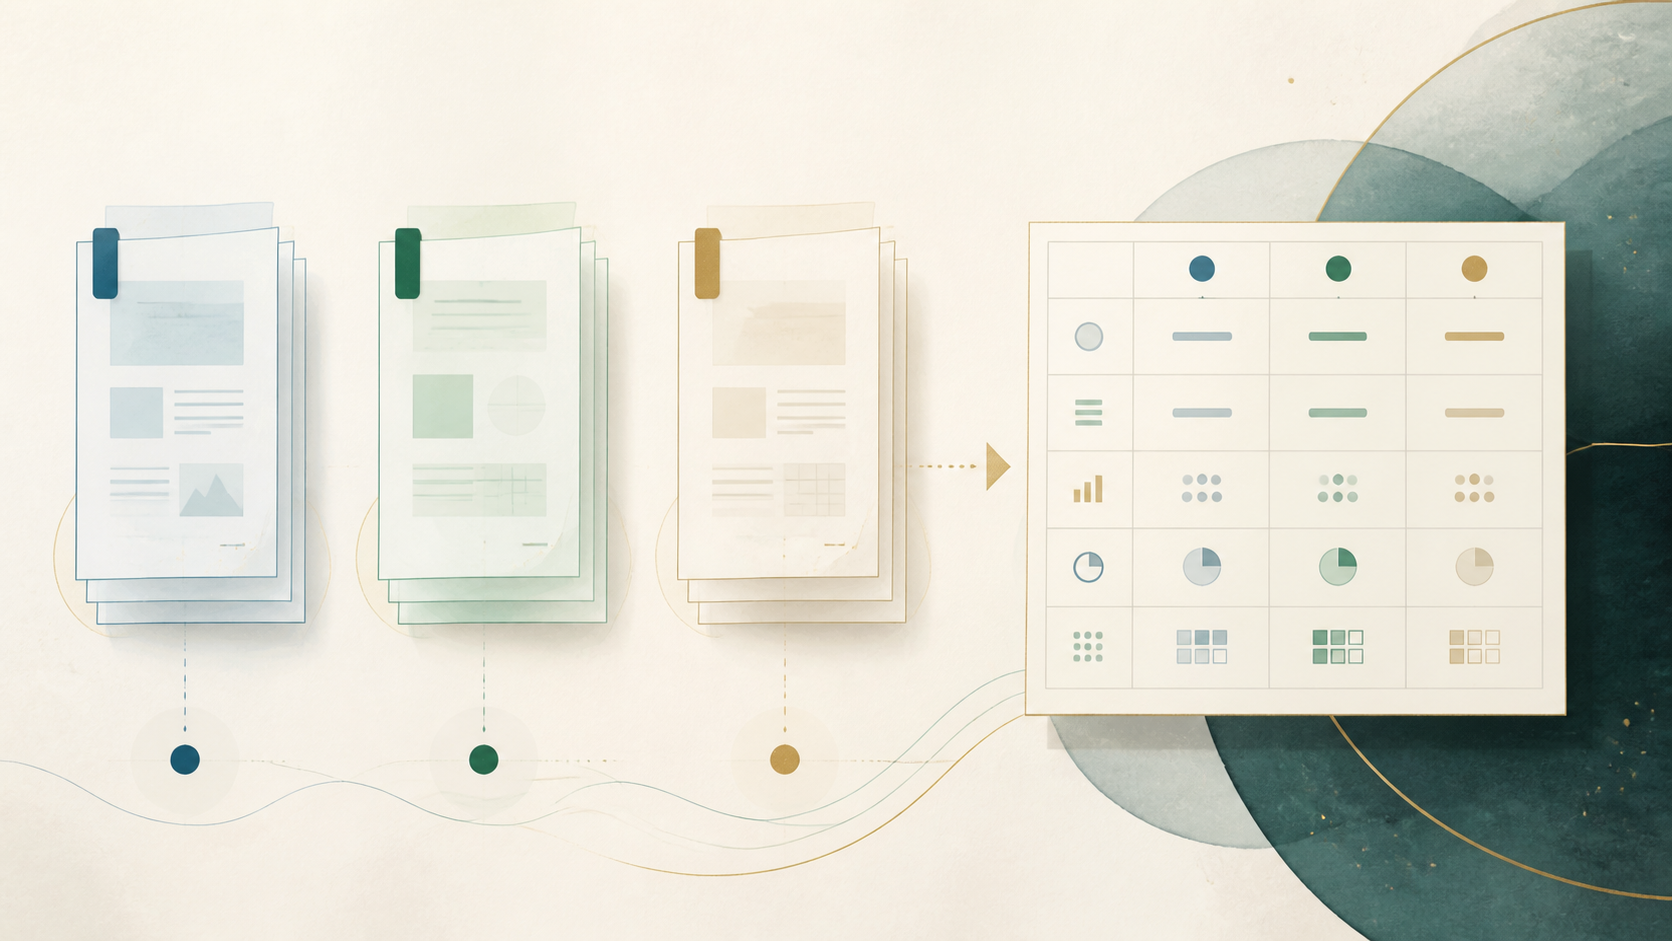
資料が多い場合は、たとえば三冊ずつ比較します。各組で同じ列の比較表を作り、最後にその表だけを統合します。
1. A〜Cを個別監査して比較表1を作る
2. D〜Fを個別監査して比較表2を作る
3. 二つの表の列名と定義を確認する
4. 出典IDを残したまま統合する
途中で列の定義を変えないことが重要です。新しい種類の資料が混じったら、同じ表へ押し込まず、別グループにします。
表示された違いと、意味づけを分ける
複数PDFの比較でAIが整理できるのは、資料に存在する表記、値、並び、重複、欠損などです。
そこから先の意味は、別の問いです。
PDFに表示された事実
参照資料に書かれた説明
AIが整理した仮説
本人が感じた体感や出来事
この四つを同じ欄に入れません。一つの差分だけから、診断、原因、治療判断、効果、病気との因果を決めないことも大切です。
複数の資料を扱うほど、AIの説明を増やすより、資料IDと「不明」を残すほうが比較は強くなります。
最初に混ぜない。別々に読めた範囲を確認する。同じ土俵だけを共通軸で比べる。そして、原資料へ戻れる住所を残す。
この順番なら、見栄えのよい比較表を作ることより、「何と何を比べたのか」を確かめられるようになります。
※本稿は、複数の資料を整理・照合する一般的な方法です。医療上の診断、治療、効果判定を目的とするものではありません。