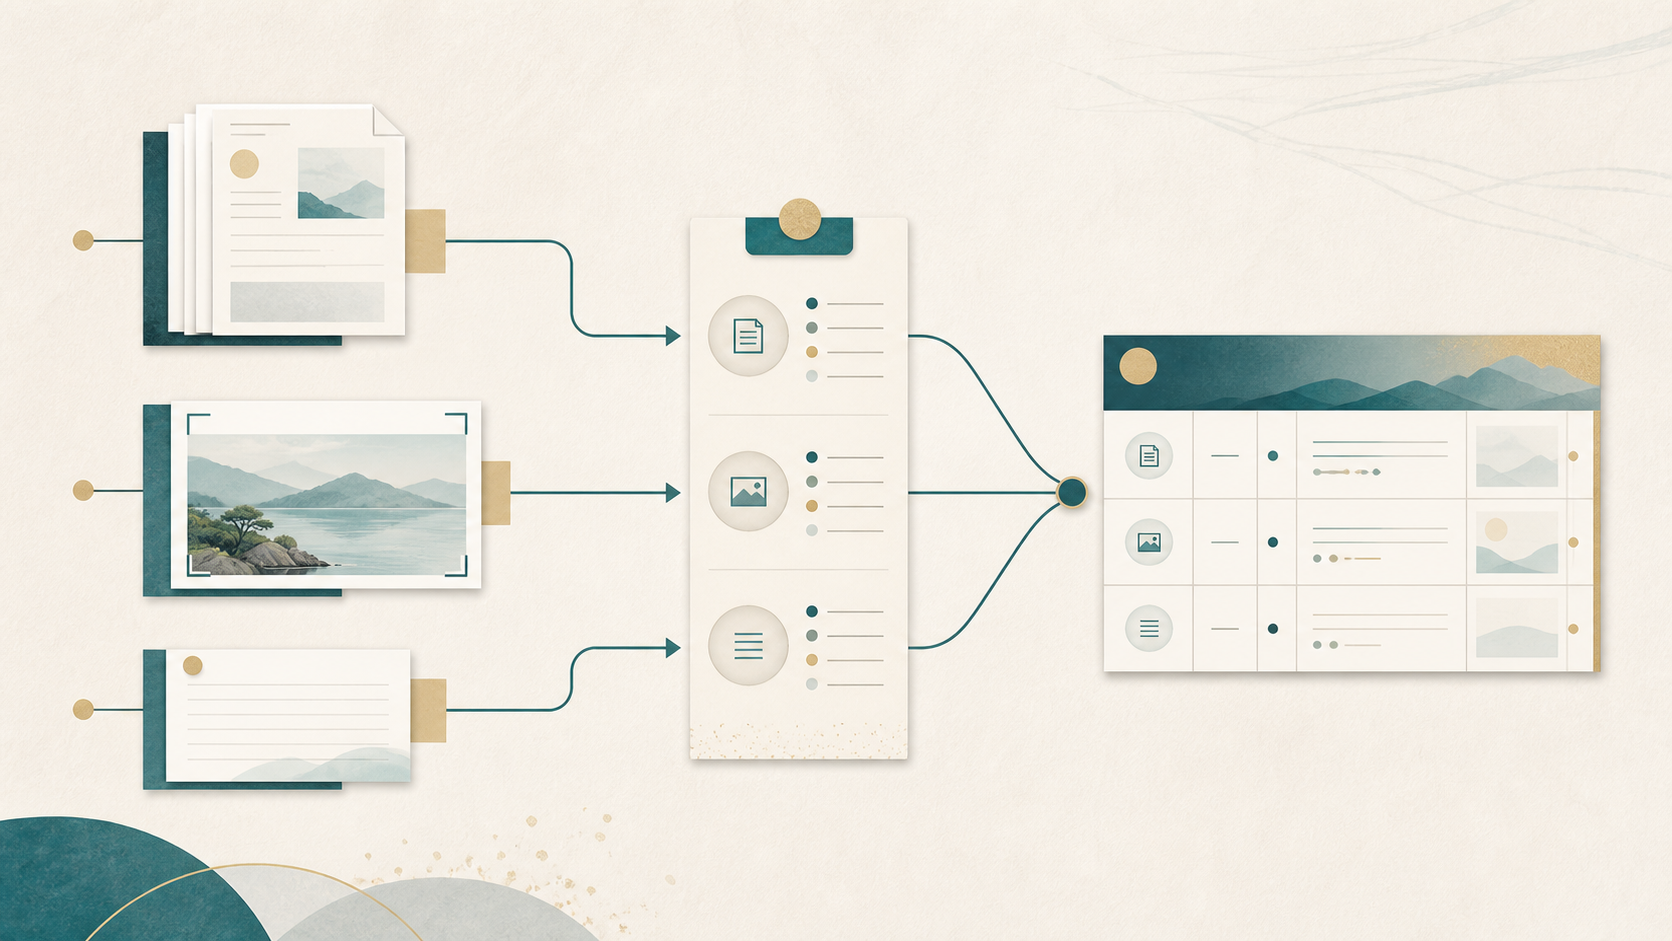
HealyのPDFが一つ。読めなかった箇所のスクショが二枚。その日の体感を記した文章メモもある。
材料が揃うほど、まとめてChatGPTへ送りたくなります。けれど、最初から全部を一つの質問に入れると、PDFの表示、画像から読んだ文字、自分のメモが同じ根拠のように混ざることがあります。
画像・PDF・文章を一緒に扱うときは、最初に資料目録だけを渡し、次にPDF → 補足画像 → 文章メモの順で資料IDごとに個別確認します。PDFと画像の対応箇所、文章が本人の記録であることを確認した後、最後に出典ID付きで統合質問します。受け取った直後から解釈させないことが重要です。
順番の目的は、AIに分かりやすくするだけではありません。後から「この説明は何を根拠にしたのか」を自分で確かめられるようにすることです。
最初に、資料そのものではなく目録を渡す
添付前に、今回使う材料を一覧にします。資料ID/形式/役割/日時/対象範囲、という並びです。
P1はPDFで主資料、全5ページ。I1は画像で、P1の3ページ下部の補足、項目4〜8。I2は画像で、P1の5ページの拡大、最終表。T1は文章で、本人の出来事・体感メモ。
ここで、役割を決めます。
PDFは、資料全体の構造を確認する主資料
スクショは、PDFで読めない部分を補う資料
文章は、画面表示ではなく本人の記録
形式が違うだけでなく、根拠の種類も違います。T1に書いた体感を、P1の表示事実として扱わせません。
1番目|PDFを単独で確認する
まずP1だけを添付します。
これは主資料P1です。まだ画像I1・I2や文章T1とは統合しないでください。総ページ数、ページごとの見出し、項目数、読めない箇所を示してください。確認できない内容は推測せず「不明」としてください。
PDFで読めた範囲と、読めなかった範囲を先に確定します。
OpenAIの公式FAQでは、ファイルアップロードは文書の抽出・変換・比較などに使えると案内されています。ただし、PDFの作り方や利用環境によって、文字、画像、図表の扱われ方は同じとは限りません。きれいな要約が返っても、全ページ・全要素を読めた証明にはなりません。
PDFの読み取り監査が終わるまで、スクショで内容を上書きしません。
2番目|画像を一枚ずつ補足する
次にI1を送ります。送信時に、P1のどこを補う画像かを書きます。
これは補足画像I1です。P1の3ページ下部、項目4〜8に対応します。まずI1だけから表示文字を転記し、P1で読めた文字、P1で不明だった文字、新たに確認できた文字を分けてください。まだ全体の意味は説明しないでください。
I2も同じように別のメッセージで処理します。
OpenAIの画像入力FAQでは、画像内の文字を拡大しつつ重要な詳細を切り取らないこと、画像の向き、非ラテン文字、小さい文字などに注意が必要とされています。
複数枚を一度に送る場合でも、各画像にI1、I2とIDを付け、どのPDF・ページ・領域に対応するかを明記します。
3番目|文章メモを原文として隔離する
最後にT1を送ります。
文章メモはPDFの補足説明ではなく、本人の記録です。コードブロックで囲みます。
T1を要約せず、出来事、本人の言葉による体感、本人の解釈、日時不明の記述に分けてください。P1・I1・I2との関連や因果はまだ判断しないでください。
PDF、画像、文章の個別処理が終わってから、はじめて対応表を作ります。
各資料の「受領票」を作る
資料を一つ処理するたび、AIに短い受領票を更新させます。資料ID/受領/読取状態/対応先/未確認、という列です。
たとえば、次のように残します。
P1:受領済み、3ページ下部は不明
I1:受領済み、P1・3ページ下部に対応
I2:受領済み、P1・5ページに対応
T1:受領済み、本人の文章記録。資料表示ではない
これで、AIが「I1はどの画像でしたか」と取り違えたとき、統合前に気づけます。
対応関係は人が確認する
AIが「このスクショはPDFの3ページでしょう」と推測しても、それだけで確定しません。
次を原資料で確認します。
PDFと画像の見出しが一致するか
前後の項目名が一致するか
日時が同じか
値と単位の位置が対応するか
別の結果や別人の資料ではないか
確認できたものを「対応確定」、候補だけのものを「対応未確認」とします。対応未確認の画像でPDFの不明箇所を埋めません。
最後に、出典付きで統合する
個別確認と対応関係が揃った後、統合質問をします。
P1、I1、I2、T1を統合してください。ただし、各記述に根拠IDを付けてください。出力を、PDF・画像で確認した表示事実/本人の文章記録/参照資料上の説明/AIの仮説/不明・矛盾の五区分にしてください。I1・I2は対応確定箇所だけP1の補足に使い、T1を資料表示として扱わないでください。根拠が複数ある場合はすべてのIDを示し、根拠がない説明は作らないでください。まだ診断、原因、治療判断、効果、病気との因果を決めないでください。
統合表の列は、論点/確認内容/情報区分/根拠ID・位置/不明・矛盾、という形が使えます。
根拠IDが空欄の行は、原資料に戻れない説明です。残すなら「AIの仮説」として明示し、事実欄へ移しません。
食い違いは、AIに丸めさせない
PDFとスクショの文字が違う。文章メモの日付とPDFの日付が合わない。こうした食い違いが出たとき、自然な一つの物語へ統合させないことが大切です。
P1とI1の表記が食い違う箇所を、どちらかへ修正せず並記してください。考えられる確認事項は挙げても、正しい側を推測で決めないでください。
矛盾欄が残るのは失敗ではありません。元データの確認が必要だと分かった状態です。
一度に送れる量と、理解できる量は別
ファイルや画像を複数添付できても、最初から全部を統合する必要はありません。
資料が多いときは、同じ役割ごとに小分けにします。
1. PDFの目録と個別監査
2. 補足画像の目録と対応確認
3. 文章メモの原文整理
4. 受領票の照合
5. 統合質問
「たくさん送れた」は作業の完了ではありません。「どの資料が、どこまで読めて、何に対応するか」が確認できたら、統合の準備ができています。
画像・PDF・文章を扱うときも、表示事実、参照資料上の説明、AIの仮説、本人の体感を分けます。一つの資料や重なりだけから、医療的な結論を出しません。
最初に目録を作る。一つずつ読む。対応関係を確かめる。最後に出典付きで統合する。
この順番なら、情報が多くても、一つのもっともらしい答えに溶かすのではなく、材料同士の関係を検品できます。
※本稿は、複数形式の情報を整理・照合する一般的な方法です。医療上の診断、治療、効果判定を目的とするものではありません。